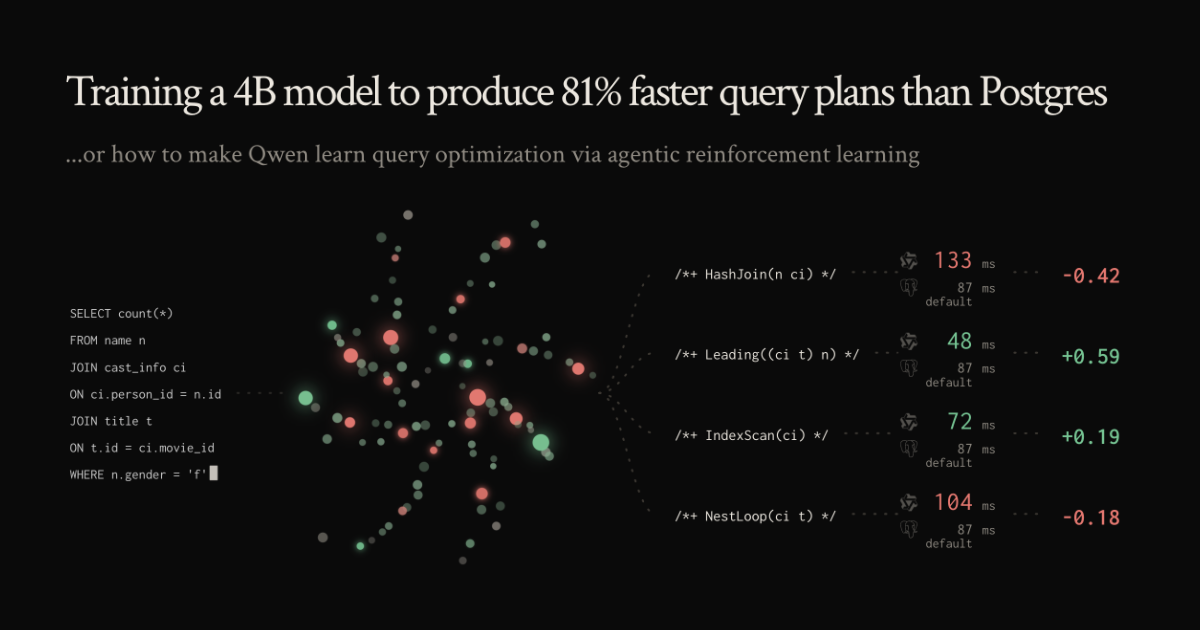
Trong thế giới của các ứng dụng web hiệu suất cao và hệ thống dữ liệu lớn, tốc độ truy vấn cơ sở dữ liệu là yếu tố sống còn. Một kế hoạch truy vấn chậm có thể biến một ứng dụng mượt mà thành một trải nghiệm đầy bực bội. Tại ChillCode Studio, chúng tôi luôn tìm kiếm những công nghệ tiên tiến nhất để đảm bảo các giải pháp của mình không chỉ mạnh mẽ mà còn cực kỳ nhanh chóng. Chính vì vậy, tin tức về QORL – một hệ thống sử dụng mô hình ngôn ngữ lớn (LLM) 4 tỷ tham số để tạo ra các kế hoạch truy vấn nhanh hơn Postgres tới 81% – đã thực sự thu hút sự chú ý của chúng tôi. Đây không chỉ là một cải tiến về hiệu suất; đây là một sự thay đổi mô hình trong cách chúng ta tư duy về tối ưu hóa cơ sở dữ liệu.
Nút thắt cổ chai: Bộ tối ưu hóa truy vấn truyền thống #
Trước khi đi sâu vào QORL, hãy cùng xem xét lý do tại sao bộ tối ưu hóa truy vấn truyền thống, như của Postgres, lại trở thành một "nút thắt cổ chai" trong nhiều trường hợp. Các hệ quản trị cơ sở dữ liệu (DBMS) hiện đại đều có một bộ tối ưu hóa truy vấn (Query Optimizer) mạnh mẽ. Nhiệm vụ của nó là biến một câu lệnh SQL khai báo (chỉ định cái gì cần lấy) thành một kế hoạch thực thi thủ tục hiệu quả nhất (chỉ định làm thế nào để lấy). Quá trình này thường dựa trên mô hình chi phí (cost-based model), ước tính chi phí cho mỗi thao tác (scan, join, sort, aggregate) dựa trên thống kê dữ liệu (kích thước bảng, số lượng hàng, phân phối dữ liệu, chỉ mục có sẵn).
Vấn đề nảy sinh khi:
- Độ phức tạp của truy vấn: Các truy vấn phức tạp với nhiều phép join, subquery, CTEs khiến không gian tìm kiếm kế hoạch thực thi trở nên khổng lồ.
- Thống kê dữ liệu không hoàn hảo: Thống kê có thể lỗi thời hoặc không đủ chi tiết để phản ánh đúng phân phối dữ liệu, dẫn đến ước tính chi phí sai lệch.
- Mô hình chi phí tĩnh: Mô hình chi phí thường là tĩnh và không hoàn toàn phản ánh hiệu suất thực tế trên phần cứng hiện đại với các tầng bộ nhớ đệm phức tạp.
- Thời gian tối ưu hóa: Với các truy vấn rất phức tạp, bản thân việc tìm kiếm kế hoạch tối ưu cũng có thể tốn thời gian đáng kể, đặc biệt trong các hệ thống đòi hỏi độ trễ thấp.
Những hạn chế này có thể dẫn đến việc tạo ra các kế hoạch truy vấn kém hiệu quả, gây lãng phí tài nguyên CPU, I/O và tăng độ trễ đáng kể. Điều này trực tiếp ảnh hưởng đến Core Web Vitals của ứng dụng, đặc biệt là các chỉ số như LCP (Largest Contentful Paint) và FID (First Input Delay) nếu dữ liệu backend là yếu tố quyết định.

QORL: Một thay đổi mô hình với Học Tăng Cường và LLM #
QORL (Query Optimization with Reinforcement Learning) tiếp cận vấn đề này từ một góc độ hoàn toàn mới, biến việc tối ưu hóa truy vấn thành một bài toán Học Tăng Cường (Reinforcement Learning - RL). Thay vì dựa vào các quy tắc và mô hình chi phí được định nghĩa trước, QORL học cách tạo ra các kế hoạch tối ưu thông qua trải nghiệm.
Cơ chế hoạt động cốt lõi: #
- Môi trường RL: Môi trường ở đây là một bộ mô phỏng cơ sở dữ liệu hoặc chính cơ sở dữ liệu, nơi các kế hoạch truy vấn được thực thi và chi phí thực tế được đo lường.
- Trạng thái (State): Đại diện cho truy vấn hiện tại, lược đồ cơ sở dữ liệu, thống kê dữ liệu và các phần của kế hoạch đã được tạo ra.
- Hành động (Action): LLM đóng vai trò là tác nhân (agent) RL, thực hiện các "hành động" bằng cách đề xuất các toán tử (operators) cơ sở dữ liệu (ví dụ:
SeqScan,IndexScan,HashJoin,MergeJoin) và thứ tự thực thi của chúng để xây dựng một kế hoạch truy vấn. - Phần thưởng (Reward): Phần thưởng được tính toán dựa trên chi phí thực thi của kế hoạch truy vấn. Kế hoạch càng nhanh, phần thưởng càng cao. Đây là điểm mấu chốt: QORL học từ hiệu suất thực tế, không chỉ là ước tính.
Vai trò của LLM 4B: "Bộ não" tạo kế hoạch #
LLM 4 tỷ tham số là trái tim của QORL. Nó không chỉ đơn thuần là một mô hình ngôn ngữ mà được huấn luyện để hoạt động như một chính sách (policy network) trong khuôn khổ RL. LLM này được cung cấp thông tin về truy vấn SQL, lược đồ cơ sở dữ liệu, và thống kê, sau đó tạo ra một chuỗi các toán tử và tham số của chúng để hình thành một kế hoạch truy vấn hoàn chỉnh.
Quá trình huấn luyện bao gồm:
- Tạo dữ liệu huấn luyện: Sử dụng một lượng lớn các truy vấn SQL và thực thi chúng trên một môi trường cơ sở dữ liệu để thu thập các kế hoạch thực tế và chi phí của chúng.
- Học Tăng Cường: LLM được huấn luyện để tối đa hóa phần thưởng (tức là giảm thiểu chi phí thực thi). Nó học cách liên kết các đặc điểm của truy vấn với các chiến lược tạo kế hoạch hiệu quả.
- Fine-tuning: LLM có thể được tinh chỉnh trên các tập dữ liệu cụ thể để phù hợp với đặc điểm tải công việc (workload) của một hệ thống nhất định.
Kiến trúc và luồng dữ liệu chuyên sâu #
Hãy cùng phân tích kiến trúc của QORL để hiểu rõ luồng dữ liệu và cơ chế hoạt động chi tiết hơn.
- Query Input & Parsing:
- Một truy vấn SQL đầu vào được gửi đến hệ thống QORL.
- Bộ phân tích cú pháp (parser) sẽ chuyển đổi SQL thành một biểu diễn trung gian (Intermediate Representation - IR), thường là một cây cú pháp trừu tượng (Abstract Syntax Tree - AST) hoặc một biểu diễn đồ thị. IR này sẽ chứa tất cả thông tin về các bảng, cột, điều kiện lọc, phép join, v.v.
- State Representation & Feature Extraction:
- Từ IR của truy vấn, cùng với lược đồ cơ sở dữ liệu và thống kê hiện tại (ví dụ: kích thước bảng, số lượng giá trị duy nhất, phân phối dữ liệu), một "trạng thái" được mã hóa thành vector hoặc chuỗi văn bản sẽ được tạo ra.
- Đây là đầu vào cho LLM. Việc mã hóa trạng thái phải đủ giàu thông tin để LLM có thể đưa ra quyết định thông minh.
- LLM-Powered Plan Generation (Policy Network):
- Trạng thái được đưa vào LLM 4B. Dựa trên chính sách đã học, LLM sẽ tạo ra một chuỗi các "hành động" – tức là các toán tử cơ sở dữ liệu và các tham số của chúng.
- Ví dụ, thay vì chỉ chọn
HashJoin, LLM có thể quyết định thứ tự join, chọn bảng bên trong/bên ngoài, và các chỉ mục cụ thể để sử dụng. Quá trình này có thể lặp lại, nơi LLM đưa ra các quyết định tuần tự để xây dựng từng phần của kế hoạch.
- Plan Validation & Execution:
- Kế hoạch truy vấn được tạo ra bởi LLM có thể cần được xác thực để đảm bảo tính hợp lệ cú pháp và ngữ nghĩa.
- Sau đó, kế hoạch này được gửi đến một công cụ thực thi (execution engine) của cơ sở dữ liệu (hoặc một bộ mô phỏng) để chạy.
- Cost Measurement & Reward Calculation:
- Thời gian thực thi và/hoặc chi phí tài nguyên (CPU, I/O) thực tế của kế hoạch được đo lường.
- Dựa trên các số liệu này, một phần thưởng được tính toán và gửi trở lại cơ chế huấn luyện RL.
- Reinforcement Learning Loop (Training):
- Phần thưởng được sử dụng để cập nhật các trọng số của LLM thông qua các thuật toán RL (ví dụ: Proximal Policy Optimization - PPO). Điều này giúp LLM học cách tạo ra các kế hoạch tốt hơn trong tương lai.
- Quá trình này diễn ra liên tục, cho phép QORL thích nghi với sự thay đổi của dữ liệu và tải công việc.

Khả năng học hỏi từ hiệu suất thực tế là điểm mạnh nhất của QORL. Nó cho phép hệ thống này vượt qua những giả định cứng nhắc của các bộ tối ưu hóa truyền thống và tìm ra các kế hoạch thực sự nhanh hơn, như mức cải thiện 81% so với Postgres đã được chứng minh. Điều này là đặc biệt quan trọng trong các hệ thống yêu cầu hiệu suất cao và độ trễ thấp, nơi mỗi mili giây đều có giá trị. Tại ChillCode, chúng tôi luôn áp dụng kiến trúc công nghệ web hiện đại để đảm bảo các giải pháp của mình có thể mở rộng và đáp ứng mọi thách thức về hiệu suất.
Code mẫu: Mô phỏng gợi ý kế hoạch truy vấn bằng LLM #
Để minh họa cơ chế hoạt động của QORL ở cấp độ khái niệm, chúng ta hãy xem xét một ví dụ Python đơn giản về cách một LLM có thể được sử dụng để gợi ý các toán tử cho một kế hoạch truy vấn. Trong thực tế, quá trình sẽ phức tạp hơn nhiều, liên quan đến việc mã hóa trạng thái chi tiết và sử dụng một LLM được huấn luyện chuyên sâu.
import json
from typing import Dict, List, Any

# Bước 1: Định nghĩa một QueryContext để mô tả truy vấn và lược đồ
class QueryContext:
    def __init__(self, sql: str, schema: Dict[str, Any], stats: Dict[str, Any]):
        self.sql = sql
        self.schema = schema
        self.stats = stats
        self.parsed_query_tree: Dict[str, Any] = self._parse_sql_to_tree(sql) # Giả định đã được parse

    def _parse_sql_to_tree(self, sql: str) -> Dict[str, Any]:
        """
        Mô phỏng việc phân tích cú pháp SQL thành một cây biểu diễn trung gian (AST).
        Trong thực tế, đây sẽ là một bộ phân tích cú pháp SQL phức tạp.
        """
        # Ví dụ đơn giản cho mục đích minh họa
        if "FROM users JOIN orders" in sql:
            return {
                "type": "SELECT",
                "tables": ["users", "orders"],
                "joins": [{"type": "INNER JOIN", "left": "users", "right": "orders", "on": "users.id = orders.user_id"}],
                "filters": ["orders.amount > 100"],
                "select_cols": ["users.name", "orders.amount"]
            }
        return {"type": "SELECT", "tables": ["unknown"]}

    def get_state_representation(self) -> str:
        """
        Chuyển đổi context thành định dạng mà LLM có thể hiểu.
        Trong thực tế, đây có thể là một chuỗi JSON hoặc một embedding vector.
        """
        return json.dumps({
            "sql": self.sql,
            "parsed_query": self.parsed_query_tree,
            "schema_summary": {table: info for table, info in self.schema.items()},
            "stats_summary": {table: info for table, info in self.stats.items()}
        })

# Bước 2: Mô phỏng LLM
class MockLLMPlanGenerator:
    def __init__(self, model_name: str = "qorl-4b-optimizer"):
        self.model_name = model_name
        # Trong thực tế, đây sẽ là việc tải một mô hình LLM đã được huấn luyện

    def generate_plan_fragment(self, state_representation: str) -> List[Dict[str, Any]]:
        """
        Mô phỏng LLM tạo ra một chuỗi các toán tử cho kế hoạch truy vấn.
        LLM sẽ nhận một biểu diễn trạng thái và trả về một chuỗi các hành động/toán tử.
        """
        # Logic đơn giản hóa: dựa vào một số từ khóa trong state_representation
        # để gợi ý kế hoạch. Trong thực tế, đây là kết quả của việc suy luận từ LLM.
        state_data = json.loads(state_representation)
        sql = state_data.get("sql", "")
        parsed_query = state_data.get("parsed_query", {})

        suggested_plan = []

        if "FROM users JOIN orders" in sql:
            # Gợi ý một kế hoạch với Index Scan và Hash Join
            suggested_plan.append({
                "operator": "IndexScan",
                "table": "users",
                "index": "users_pkey",
                "filter": None
            })
            suggested_plan.append({
                "operator": "IndexScan",
                "table": "orders",
                "index": "orders_user_id_idx", # Giả sử có index trên user_id
                "filter": "orders.amount > 100"
            })
            suggested_plan.append({
                "operator": "HashJoin",
                "left_input": "users",
                "right_input": "orders",
                "join_condition": "users.id = orders.user_id"
            })
            suggested_plan.append({
                "operator": "Project",
                "columns": parsed_query.get("select_cols", [])
            })
        else:
            suggested_plan.append({"operator": "SeqScan", "table": "unknown_table"})
            suggested_plan.append({"operator": "Project", "columns": ["*"]})

        return suggested_plan

# Bước 3: Hàm chính để thực hiện tối ưu hóa
def optimize_query_with_qorl(sql_query: str, db_schema: Dict[str, Any], db_stats: Dict[str, Any]):
    """
    Tích hợp các thành phần để mô phỏng quá trình tối ưu hóa QORL.
    """
    print(f"[{'-'*10} Bắt đầu tối ưu hóa truy vấn {'-'*10}]")
    print(f"Truy vấn SQL: {sql_query}\n")

    # 1. Chuẩn bị ngữ cảnh truy vấn
    query_ctx = QueryContext(sql_query, db_schema, db_stats)
    state_rep = query_ctx.get_state_representation()
    print("Biểu diễn trạng thái cho LLM:")
    print(json.dumps(json.loads(state_rep), indent=2))
    print("\n")

    # 2. LLM tạo kế hoạch
    llm_optimizer = MockLLMPlanGenerator()
    suggested_plan = llm_optimizer.generate_plan_fragment(state_rep)
    print("Kế hoạch truy vấn được LLM gợi ý (dạng toán tử):")
    for step in suggested_plan:
        print(f"- {step['operator']}: {step}")
    print("\n")

    # 3. Trong một hệ thống thực tế:
    #    - Kế hoạch này sẽ được chuyển đổi thành định dạng thực thi của DBMS.
    #    - Thực thi kế hoạch và đo lường chi phí thực tế.
    #    - Gửi phản hồi (reward) về cho LLM để huấn luyện thêm.
    print("[Hệ thống thực tế sẽ thực thi kế hoạch và thu thập phản hồi để huấn luyện LLM.]")
    print(f"[{'-'*10} Kết thúc tối ưu hóa {'-'*10}]")

# Dữ liệu mẫu (giả định)
sample_schema = {
    "users": {"columns": ["id", "name", "email"], "indexes": ["id_pkey", "email_idx"]},
    "orders": {"columns": ["order_id", "user_id", "amount", "order_date"], "indexes": ["order_id_pkey", "user_id_idx"]}
}

sample_stats = {
    "users": {"row_count": 1000000, "avg_row_size": 100},
    "orders": {"row_count": 5000000, "avg_row_size": 150}
}

# Ví dụ sử dụng:
if __name__ == "__main__":
    sql_query_example = "SELECT u.name, o.amount FROM users u JOIN orders o ON u.id = o.user_id WHERE o.amount > 100;"
    optimize_query_with_qorl(sql_query_example, sample_schema, sample_stats)

    print("\n" + "="*50 + "\n")

    sql_simple_example = "SELECT name FROM users WHERE id = 5;"
    optimize_query_with_qorl(sql_simple_example, sample_schema, sample_stats)
Giải thích chi tiết từng bước của khối code: #
QueryContextClass:- Mục đích: Đại diện cho ngữ cảnh của một truy vấn SQL, bao gồm chính câu lệnh SQL, lược đồ cơ sở dữ liệu và các thống kê liên quan.
_parse_sql_to_tree(self, sql: str): Hàm này mô phỏng quá trình phân tích cú pháp SQL. Trong một hệ thống thực tế, đây là một bộ phân tích cú pháp phức tạp sẽ chuyển đổi SQL thành một cấu trúc dữ liệu có thể dễ dàng xử lý bởi máy tính (ví dụ: Abstract Syntax Tree - AST). Ví dụ của chúng ta đơn giản hóa thành một từ điển Python.get_state_representation(self) -> str: Đây là bước quan trọng để chuẩn bị dữ liệu cho LLM. Nó chuyển đổi toàn bộ ngữ cảnh truy vấn thành một chuỗi (ở đây là JSON) mà LLM có thể đọc và hiểu. Trong QORL thực tế, biểu diễn này có thể là một chuỗi văn bản được mã hóa cẩn thận hoặc một vector embedding giàu thông tin.
MockLLMPlanGeneratorClass:- Mục đích: Mô phỏng hoạt động của LLM 4 tỷ tham số trong việc tạo ra các phần của kế hoạch truy vấn.
generate_plan_fragment(self, state_representation: str) -> List[Dict[str, Any]]: Đây là hàm cốt lõi. Nó nhậnstate_representationtừQueryContext. Trong một hệ thống QORL thực tế, LLM sẽ sử dụng biểu diễn này để suy luận và tạo ra một chuỗi các toán tử cơ sở dữ liệu (ví dụ:IndexScan,HashJoin,Project) cùng với các tham số của chúng. Ví dụ này sử dụng logic đơn giản dựa trên từ khóa để minh họa cách LLM có thể "quyết định" các toán tử. LLM sẽ học cách đưa ra các quyết định này thông qua quá trình huấn luyện RL.
optimize_query_with_qorlFunction:- Mục đích: Điều phối toàn bộ quá trình, từ việc chuẩn bị ngữ cảnh đến việc LLM gợi ý kế hoạch.
- Bước 1: Chuẩn bị ngữ cảnh: Tạo một đối tượng
QueryContextvà lấy biểu diễn trạng thái. - Bước 2: LLM tạo kế hoạch: Khởi tạo
MockLLMPlanGeneratorvà gọigenerate_plan_fragmentđể nhận kế hoạch gợi ý. - Bước 3 (Trong một hệ thống thực tế): Phần này giải thích rằng trong một triển khai thực tế, kế hoạch được LLM gợi ý sẽ được chuyển đổi sang định dạng mà DBMS có thể hiểu, sau đó thực thi