
Trong kỷ nguyên của Trí tuệ Nhân tạo tạo sinh (Generative AI), các mô hình ngôn ngữ lớn (LLM) đã chứng minh sức mạnh phi thường, mở ra vô số khả năng mới cho ứng dụng. Tuy nhiên, cùng với sự mạnh mẽ đó là những thách thức không nhỏ về hiệu năng, chi phí và độ phức tạp trong quản lý. Tại ChillCode Studio, chúng tôi luôn tìm kiếm những giải pháp tiên tiến để giải quyết các vấn đề này, và "System One Models" cùng với Jev của Typesafe.ai là một hướng đi đầy hứa hẹn.
Bài viết này sẽ đi sâu phân tích cơ chế hoạt động, luồng xử lý dữ liệu và cấu trúc giải pháp của System One Models và Jev, đồng thời lồng ghép các nguyên lý tối ưu Core Web Vitals để mang lại giá trị thực tế cao cho các kỹ sư và nhà phát triển.
Bối cảnh: Thách thức của LLM trong sản xuất #
Sự bùng nổ của các LLM như GPT-4, Claude 3 hay Gemini đã thay đổi cách chúng ta tương tác với công nghệ. Tuy nhiên, việc đưa các mô hình này vào môi trường sản xuất đòi hỏi nhiều hơn là chỉ gọi API. Các thách thức chính bao gồm:
- Chi phí cao: Mỗi lần gọi API tới LLM đều tốn kém, đặc biệt với các mô hình lớn và các tác vụ lặp lại.
- Độ trễ (Latency): Thời gian phản hồi của LLM có thể kéo dài, ảnh hưởng trực tiếp đến trải nghiệm người dùng, đặc biệt trong các ứng dụng thời gian thực.
- Quản lý tài nguyên: Việc lựa chọn mô hình phù hợp cho từng tác vụ, tối ưu hóa băng thông và xử lý lỗi là một bài toán phức tạp.
- Độ tin cậy và nhất quán: Đảm bảo LLM hoạt động ổn định và đưa ra kết quả nhất quán là điều cần thiết.
Đây chính là lúc các khái niệm như System One Models và kiến trúc điều phối thông minh như Jev phát huy vai trò quan trọng.
System One Models: Tư duy nhanh cho AI #
Khái niệm "System One Models" được lấy cảm hứng từ công trình của nhà tâm lý học Daniel Kahneman về hai hệ thống tư duy của con người:
- System 1 (Hệ thống 1): Nhanh, trực giác, tự động, ít tốn công sức. Ví dụ: nhận diện khuôn mặt, trả lời 2+2.
- System 2 (Hệ thống 2): Chậm, có ý thức, phân tích, đòi hỏi nỗ lực. Ví dụ: giải một bài toán phức tạp, lập luận logic.
Áp dụng vào AI, System One Models là các mô hình LLM được tinh chỉnh hoặc có kích thước nhỏ hơn, được thiết kế để xử lý nhanh chóng các tác vụ đơn giản, lặp lại hoặc có độ phức tạp thấp. Chúng hoạt động giống như "phản xạ" của hệ thống AI, cung cấp câu trả lời gần như tức thì với chi phí thấp hơn đáng kể.
Cơ chế hoạt động:
System One Models không thay thế hoàn toàn các LLM lớn (System Two Models) mà bổ trợ cho chúng. Thay vì gửi mọi yêu cầu đến mô hình mạnh nhất và đắt nhất, một hệ thống thông minh có thể:
- Phân loại tác vụ: Đánh giá độ phức tạp của prompt đầu vào.
- Định tuyến thông minh: Nếu tác vụ đơn giản, gửi đến System One Model. Nếu phức tạp, gửi đến System Two Model.
- Học hỏi liên tục: Cải thiện khả năng phân loại và định tuyến dựa trên hiệu suất và chi phí thực tế.
Lợi ích rõ ràng là giảm đáng kể chi phí vận hành và cải thiện tốc độ phản hồi cho phần lớn các yêu cầu.

Jev: Kiến trúc điều phối thông minh cho LLM #
Jev, được phát triển bởi Typesafe.ai, là một nền tảng điều phối (orchestration layer) được thiết kế để quản lý và tối ưu hóa các tương tác với LLM. Nó hoạt động như một "bộ não" trung tâm, đưa ra quyết định thông minh về cách xử lý từng yêu cầu LLM, từ đó giải quyết các thách thức về hiệu năng và chi phí.
1. Luồng xử lý dữ liệu và cơ chế hoạt động #
Hãy hình dung một yêu cầu truy vấn đi qua Jev:
- Bước 1: Tiếp nhận yêu cầu (Prompt Ingestion): Ứng dụng của bạn gửi một prompt tới Jev API endpoint, thay vì trực tiếp tới LLM.
- Bước 2: Phân tích và tiền xử lý (Analysis & Pre-processing): Jev phân tích prompt để hiểu ý định, độ phức tạp, và các yếu tố ngữ cảnh. Nó có thể sử dụng các mô hình nhỏ hơn, nhanh hơn (System One) để phân loại prompt hoặc trích xuất các thực thể quan trọng.
- Bước 3: Kiểm tra Cache (Cache Lookup): Jev kiểm tra bộ nhớ đệm nội bộ (cache). Nếu một prompt tương tự đã được xử lý trước đó và có kết quả hợp lệ, Jev sẽ trả về kết quả từ cache ngay lập tức. Đây là một yếu tố cực kỳ quan trọng để giảm độ trễ và chi phí, trực tiếp cải thiện Time To First Byte (TTFB).
- Bước 4: Định tuyến thông minh (Intelligent Routing): Nếu không có trong cache, Jev sẽ sử dụng các thuật toán định tuyến để quyết định mô hình LLM nào phù hợp nhất:
- System One Model (nhỏ, nhanh, rẻ): Cho các tác vụ đơn giản, trả lời trực tiếp, hoặc các yêu cầu đã biết trước.
- System Two Model (lớn, mạnh, đắt): Cho các tác vụ phức tạp, đòi hỏi suy luận sâu, sáng tạo hoặc cần độ chính xác cao.
- Jev có thể sử dụng các yếu tố như độ dài prompt, từ khóa, ngữ cảnh, hoặc thậm chí là các mô hình phân loại nhỏ để đưa ra quyết định này.
- Bước 5: Thực thi và Tối ưu (Execution & Optimization): Jev gửi prompt tới mô hình LLM đã chọn. Nó cũng có thể áp dụng các chiến lược như:
- Song song hóa (Parallelization): Gửi cùng một prompt đến nhiều mô hình và chọn kết quả tốt nhất/nhanh nhất.
- Thử lại (Retries) và Dự phòng (Fallbacks): Nếu một mô hình thất bại hoặc phản hồi chậm, Jev có thể tự động thử lại hoặc chuyển sang mô hình dự phòng.
- Tối ưu hóa token: Đảm bảo prompt được gửi đi hiệu quả nhất, giảm thiểu số lượng token không cần thiết.
- Bước 6: Ghi Cache và Trả kết quả (Cache & Respond): Kết quả từ LLM được lưu vào cache để sử dụng cho các yêu cầu sau và được trả về cho ứng dụng gốc. Việc này góp phần giảm Largest Contentful Paint (LCP) cho các thành phần UI phụ thuộc vào LLM.
- Bước 7: Quan sát và Phân tích (Observability & Analytics): Jev liên tục thu thập dữ liệu về hiệu suất của các mô hình, chi phí, độ trễ và tỷ lệ lỗi. Dữ liệu này được sử dụng để tinh chỉnh các thuật toán định tuyến và ra quyết định trong tương lai.
2. Các thành phần chính của Jev #
- API Gateway: Điểm vào duy nhất cho mọi yêu cầu LLM.
- Prompt Analyzer: Phân tích ngữ nghĩa và cấu trúc của prompt.
- Caching Layer: Bộ nhớ đệm phân tán để lưu trữ các phản hồi LLM đã biết.
- Routing Engine: Trái tim của Jev, chứa logic quyết định mô hình nào sẽ được sử dụng.
- Model Adapters: Các lớp trừu tượng hóa (abstraction layers) để tương tác với các nhà cung cấp LLM khác nhau (OpenAI, Anthropic, Google...).
- Telemetry & Monitoring: Hệ thống thu thập và phân tích dữ liệu hiệu suất.
- Cost Management Module: Theo dõi và báo cáo chi phí theo thời gian thực.
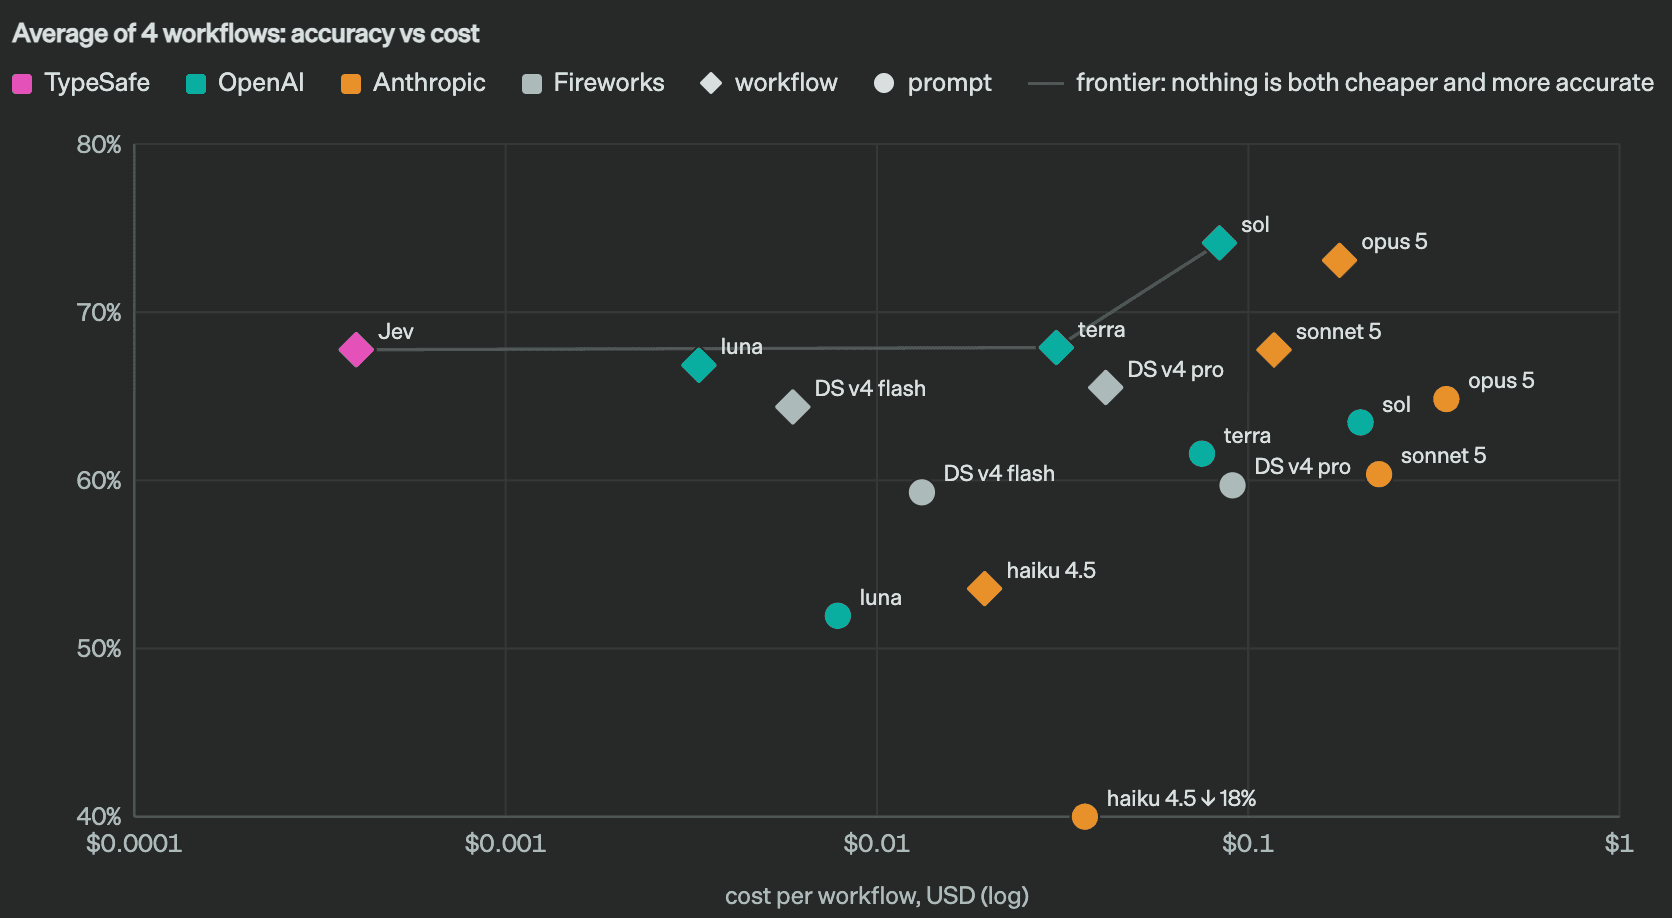
3. Tối ưu Core Web Vitals và quản lý tài nguyên #
Jev đóng vai trò then chốt trong việc tối ưu hóa hiệu suất ứng dụng web và di động, đặc biệt là các ứng dụng phụ thuộc vào phản hồi từ LLM:
- Giảm độ trễ (Latency Reduction):
- Cache hiệu quả: Trả về kết quả tức thì cho các truy vấn lặp lại, giảm TTFB xuống mức tối thiểu (gần 0ms).
- Định tuyến thông minh: Chọn System One Model cho tác vụ đơn giản giúp phản hồi nhanh hơn đáng kể so với việc chờ đợi System Two Model. Điều này trực tiếp cải thiện First Contentful Paint (FCP) và TTFB.
- Song song hóa và thử lại: Tăng cường độ tin cậy và giảm thời gian chờ đợi do lỗi hoặc quá tải của một mô hình cụ thể.
- Quản lý tài nguyên và chi phí:
- Sử dụng mô hình phù hợp: Đảm bảo rằng bạn không dùng "súng bắn ruồi" (mô hình lớn, đắt tiền) cho những tác vụ đơn giản, tiết kiệm chi phí đáng kể.
- Giảm số lần gọi API: Cache giúp giảm số lượng yêu cầu gửi đến các nhà cung cấp LLM, trực tiếp giảm chi phí.
- Quan sát chi phí: Cung cấp khả năng hiển thị chi phí chi tiết, giúp đội ngũ có thể điều chỉnh chiến lược.
- Cải thiện trải nghiệm người dùng:
- Phản hồi nhanh hơn đồng nghĩa với tương tác mượt mà hơn, giảm tỷ lệ thoát trang và tăng sự hài lòng của người dùng. Đối với các ứng dụng có nhiều thành phần động dựa trên LLM, việc giảm độ trễ giúp Largest Contentful Paint (LCP) tốt hơn.
- Độ tin cậy cao hơn giảm thiểu các lỗi hiển thị hoặc thời gian chờ đợi không mong muốn.
Các giải pháp như Jev không chỉ là công cụ hỗ trợ mà còn là nền tảng cốt lõi cho các kiến trúc công nghệ web hiện đại và các ứng dụng AI hiệu suất cao.
Code mẫu minh họa: Một Jev-like Orchestrator đơn giản (Python) #
Để minh họa cơ chế định tuyến thông minh và caching của Jev, chúng ta sẽ xây dựng một lớp SimpleLLMOrchestrator bằng Python. Lớp này sẽ mô phỏng việc chọn giữa một "mô hình nhanh" (System One) và một "mô hình chính xác" (System Two) dựa trên độ dài của prompt, và tích hợp một bộ nhớ đệm đơn giản.
import functools
import time

# Giả định các mô hình LLM
class SystemOneModel:
    """Mô hình nhanh, chi phí thấp cho các tác vụ đơn giản."""
    def __init__(self, name="FastModel"):
        self.name = name

    def generate(self, prompt: str) -> str:
        time.sleep(0.1) # Giả lập độ trễ thấp
        return f"[{self.name} - Quick response for '{prompt[:30]}...']"

class SystemTwoModel:
    """Mô hình chính xác, chi phí cao hơn cho các tác vụ phức tạp."""
    def __init__(self, name="AccurateModel"):
        self.name = name

    def generate(self, prompt: str) -> str:
        time.sleep(0.8) # Giả lập độ trễ cao hơn
        return f"[{self.name} - Detailed analysis for '{prompt[:30]}...']"

# Bộ nhớ đệm đơn giản
class SimpleCache:
    def __init__(self):
        self._cache = {}

    def get(self, key: str):
        return self._cache.get(key)

    def set(self, key: str, value):
        self._cache[key] = value
        print(f"Cache: Đã lưu kết quả cho '{key[:30]}...'")

    def clear(self):
        self._cache = {}
        print("Cache: Đã xóa toàn bộ bộ nhớ đệm.")

class SimpleLLMOrchestrator:
    """
    Một bộ điều phối LLM đơn giản mô phỏng hành vi của Jev.
    Nó định tuyến yêu cầu dựa trên độ dài prompt và sử dụng bộ nhớ đệm.
    """
    def __init__(self, cache_enabled: bool = True):
        self.system_one_model = SystemOneModel()
        self.system_two_model = SystemTwoModel()
        self.cache = SimpleCache() if cache_enabled else None
        self.PROMPT_COMPLEXITY_THRESHOLD = 50 # Ngưỡng độ dài prompt để xác định phức tạp

    def process_prompt(self, prompt: str) -> str:
        """
        Xử lý prompt: kiểm tra cache, định tuyến đến mô hình phù hợp,
        và lưu kết quả vào cache.
        """
        print(f"\n--- Xử lý prompt: '{prompt[:50]}...' ---")

        # 1. Kiểm tra Cache
        if self.cache:
            cached_response = self.cache.get(prompt)
            if cached_response:
                print(f"Cache Hit: Trả về kết quả từ cache.")
                return cached_response

        # 2. Định tuyến thông minh dựa trên độ dài prompt
        selected_model = None
        if len(prompt) < self.PROMPT_COMPLEXITY_THRESHOLD:
            selected_model = self.system_one_model
            print(f"Định tuyến: Prompt đơn giản (dài {len(prompt)} ký tự), sử dụng {selected_model.name}.")
        else:
            selected_model = self.system_two_model
            print(f"Định tuyến: Prompt phức tạp (dài {len(prompt)} ký tự), sử dụng {selected_model.name}.")

        # 3. Gọi mô hình đã chọn
        start_time = time.time()
        response = selected_model.generate(prompt)
        end_time = time.time()
        print(f"Hoàn thành gọi mô hình {selected_model.name} trong {(end_time - start_time):.2f} giây.")

        # 4. Lưu vào Cache
        if self.cache:
            self.cache.set(prompt, response)

        return response

# --- Ví dụ sử dụng ---
if __name__ == "__main__":
    orchestrator = SimpleLLMOrchestrator(cache_enabled=True)

    # Prompt đơn giản
    simple_prompt_1 = "Tóm tắt về AI."
    print(orchestrator.process_prompt(simple_prompt_1))
    print(orchestrator.process_prompt(simple_prompt_1)) # Lần 2 sẽ từ cache

    # Prompt phức tạp
    complex_prompt_1 = "Phân tích tác động của Trí tuệ Nhân tạo tạo sinh lên ngành công nghiệp phát triển phần mềm, tập trung vào các thách thức về đạo đức và bảo mật dữ liệu. Hãy đưa ra các giải pháp khả thi để giảm thiểu rủi ro."
    print(orchestrator.process_prompt(complex_prompt_1))

    # Prompt đơn giản khác
    simple_prompt_2 = "Giải thích Machine Learning."
    print(orchestrator.process_prompt(simple_prompt_2))
    print(orchestrator.process_prompt(simple_prompt_2)) # Lần 2 sẽ từ cache

    # Prompt phức tạp khác
    complex_prompt_2 = "So sánh kiến trúc transformer và recurrent neural network trong xử lý ngôn ngữ tự nhiên. Đề cập đến ưu và nhược điểm của mỗi kiến trúc, cùng với các trường hợp sử dụng tối ưu."
    print(orchestrator.process_prompt(complex_prompt_2))
Giải thích chi tiết code mẫu: #
SystemOneModelvàSystemTwoModel:- Hai lớp này mô phỏng hai loại mô hình LLM với đặc tính khác nhau:
SystemOneModel(nhanh, độ trễ 0.1s) vàSystemTwoModel(chính xác, độ trễ 0.8s). - Hàm
generategiả lập việc gọi API LLM bằng cách sử dụngtime.sleep()để tạo độ trễ.
- Hai lớp này mô phỏng hai loại mô hình LLM với đặc tính khác nhau:
SimpleCache:- Một bộ nhớ đệm cơ bản sử dụng dictionary Python.
get(key): Trả về giá trị nếu có trong cache.set(key, value): Lưu trữ cặp khóa-giá trị.- Đây là cơ chế cốt lõi giúp giảm độ trễ và chi phí cho các truy vấn lặp lại.
SimpleLLMOrchestrator:- Khởi tạo (
__init__): Khởi tạo các instance củaSystemOneModel,SystemTwoModelvàSimpleCache.PROMPT_COMPLEXITY_THRESHOLDlà một ngưỡng đơn giản (50 ký tự) để quyết định độ phức tạp của prompt. process_prompt(prompt: str): Đây là phương thức chính thực hiện logic điều phối:- 1. Kiểm tra Cache: Đầu tiên, nó cố gắng lấy phản hồi từ
self.cachebằng prompt làm khóa. Nếu tìm thấy, nó sẽ trả về ngay lập tức (Cache Hit), bỏ qua việc gọi LLM thực sự. Đây là điểm mấu chốt để tối ưu TTFB. - 2. Định tuyến thông minh: Nếu không có trong cache, nó sẽ kiểm tra
len(prompt)so vớiPROMPT_COMPLEXITY_THRESHOLD.- Nếu prompt ngắn hơn ngưỡng, nó chọn
SystemOneModel(mô hình nhanh). - Nếu prompt dài hơn hoặc bằng ngưỡng, nó chọn
SystemTwoModel(mô hình chính xác). - Logic này mô phỏng việc Jev phân tích prompt và định tuyến đến mô hình phù hợp nhất để cân bằng giữa tốc độ/chi phí và chất lượng.
- Nếu prompt ngắn hơn ngưỡng, nó chọn
- 3. Gọi mô hình đã chọn: Phương thức
generatecủa mô hình đã chọn được gọi, và thời gian thực thi được đo lường để minh họa sự khác biệt về độ trễ. - 4. Lưu vào Cache: Sau khi nhận được phản hồi từ mô hình, kết quả được lưu vào
self.cacheđể sử dụng cho các yêu cầu tương lai. - 5. Trả về phản hồi: Cuối cùng, phản hồi được trả về cho người gọi.
- 1. Kiểm tra Cache: Đầu tiên, nó cố gắng lấy phản hồi từ
- Khởi tạo (
Kết quả chạy ví dụ:
Bạn sẽ thấy rằng các prompt đơn giản được xử lý nhanh chóng bởi FastModel (0.10s), và lần gọi thứ hai của cùng một prompt sẽ trả về kết quả ngay lập tức từ cache (0.00s), không tốn thời gian gọi mô hình và không tốn chi phí. Các prompt phức tạp sẽ được xử lý bởi AccurateModel (0.80s), nhưng nếu gọi lại prompt phức tạp đó, nó cũng sẽ được lấy từ cache.
Đây là một ví dụ đơn giản nhưng minh họa rõ ràng cách Jev có thể giảm đáng kể độ trễ và chi phí bằng cách sử dụng caching và định tuyến thông minh, trực tiếp cải thiện các chỉ số Core Web Vitals của ứng dụng.
Tác động và Ứng dụng Thực tế #
Việc áp dụng System One Models và Jev mang lại những lợi ích thiết thực cho nhiều loại hình ứng dụng:
- Trợ lý ảo và Chatbot: Phản hồi nhanh hơn cho các câu hỏi thường gặp hoặc các tác vụ đơn giản, trong khi vẫn có thể xử lý các truy vấn phức tạp bằng mô hình mạnh hơn.
- Hệ thống tìm kiếm thông minh: Cải thiện tốc độ phản hồi cho các truy vấn tìm kiếm, tóm tắt nội dung nhanh chóng.
- Ứng dụng sáng tạo nội dung: Định tuyến các yêu cầu tạo tiêu đề, mô tả ngắn gọn đến System One Model và các yêu cầu tạo bài viết dài, phức tạp đến System Two Model.
- Phát triển web và giải pháp AI của ChillCode: Chúng tôi tích hợp các nguyên tắc tối ưu hiệu năng vào dịch vụ phát triển web và giải pháp AI của ChillCode để đảm bảo các sản phẩm cuối cùng không chỉ mạnh mẽ mà còn nhanh chóng và tiết kiệm chi phí.
Những dự án thực tế của ChillCode đã chứng minh rằng việc tối ưu hóa kiến trúc hạ tầng AI là chìa khóa để đạt được hiệu suất vượt trội và tối ưu chi phí vận hành.
Kết luận #
System One Models và Jev đại diện cho một bước tiến quan trọng trong việc tối ưu hóa hiệu năng và chi phí của các ứng dụng LLM. Bằng cách áp dụng tư duy "hệ thống nhanh, hệ thống chậm" vào AI và xây dựng một lớp điều phối thông minh, chúng ta có thể tạo ra các hệ thống AI linh hoạt hơn, phản hồi nhanh hơn và tiết kiệm hơn. Đối với các kỹ sư và nhà phát triển, việc nắm vững các nguyên tắc này là chìa khóa để xây dựng các giải pháp AI thế hệ mới, đáp ứng kỳ vọng về trải nghiệm người dùng và hiệu quả kinh doanh.
Tư vấn giải pháp từ ChillCode Studio:
Bạn đang tìm kiếm giải pháp xây dựng website tốc độ cao (<0.8s), tối ưu tỷ lệ chuyển đổi hoặc chuẩn bị cho kỷ nguyên AI Search? Khám phá ngay dịch vụ thiết kế landing page rẻ đẹp nhanh bàn giao chỉ từ 1-2 ngày, hoặc trải nghiệm trực tiếp bộ công cụ tính chi phí website tự động của chúng tôi.